回測過度擬合是什麼?參數試越多越危險,這 5 點一次看懂
10,000 個完全靠擲硬幣決定多空的策略裡,有 7.9% 在歷史回測中的年化夏普值超過 1。

很多人以為,只要回測期間夠長、夏普值夠高,策略就一定有東西。其實只要試的組合夠多,運氣本身就能產生漂亮的回測。這就是回測過度擬合:規則或參數被調整得太貼合過去的資料,學到的是歷史上的雜訊,而不是能重複出現的規律。AI 讓「多試幾組」變得幾乎零成本,這個問題也跟著放大。本文用一個可重現的模擬,說明過度擬合怎麼發生、怎麼辨識、怎麼降低。本文為回測方法說明,不構成投資建議。
目錄
回測過度擬合是什麼?用一句話和一個比喻說明
過度擬合的白話說法是:答案是背出來的,不是算出來的。
就像學生把歷屆考古題的答案背熟,考古題能拿滿分,換一份新考卷就不會了。回測也一樣:把均線天數、停損比例、進場時段一路調整到歷史績效最好,等於把過去這段行情「背」下來。下一段行情的走法不同,這組參數就不一定有用。
| 比較 | 找到規律 | 過度擬合 |
|---|---|---|
| 樣本內(拿來調參數的資料) | 表現不錯 | 表現非常好 |
| 樣本外(沒碰過的新資料) | 表現接近樣本內 | 明顯變差,甚至虧損 |
| 參數稍微改動 | 結果差不多 | 結果大幅變動 |
| 規則數量 | 少而簡單 | 條件很多、很細 |
為什麼參數試越多越危險?10,000 個隨機策略的模擬
本站做了一個可以重現的模擬(亂數種子 20261115):
- 假想市場:每日報酬平均 0、標準差 1%,沒有任何趨勢。
- 策略:每天隨機做多或做空,跟市場完全無關,真實的期望夏普值是 0。
- 前 500 個交易日當樣本內,後 500 個交易日當樣本外。
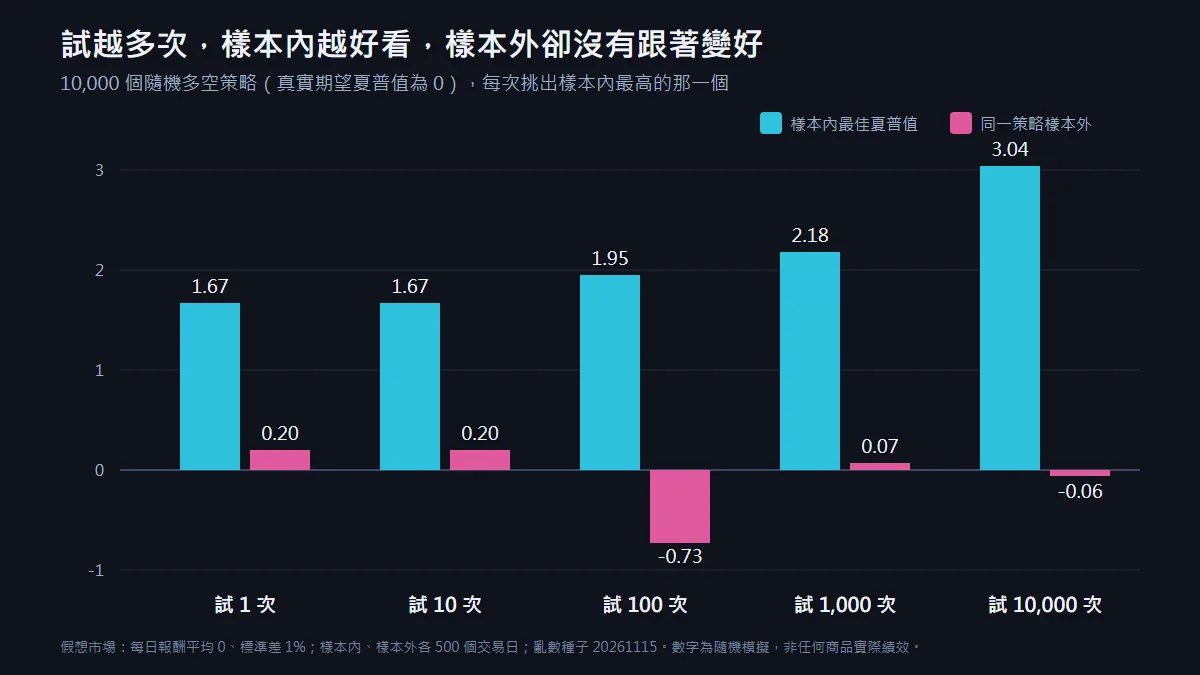
「試 N 次」的意思是只看前 N 個策略,從中挑出樣本內夏普值最高的那一個:
| 試的次數 | 樣本內最佳夏普值 | 同一個策略的樣本外夏普值 |
|---|---|---|
| 1 | 1.67 | 0.20 |
| 10 | 1.67 | 0.20 |
| 100 | 1.95 | -0.73 |
| 1,000 | 2.18 | 0.07 |
| 10,000 | 3.04 | -0.06 |
試越多次,樣本內的最佳成績越高,樣本外卻沒有跟著變好,一直在 -0.73 到 0.20 之間。 樣本內前 10 名的平均夏普值是 2.4,樣本外平均是 -0.02。第一個策略剛好有 1.67,也說明單次回測同樣可能只是運氣。
Bailey、Borwein、López de Prado 與 Zhu 在〈Pseudo-Mathematics and Financial Charlatanism〉一文中指出,試過的設定越多,回測被過度擬合的機率越高;他們另一篇論文〈The Probability of Backtest Overfitting〉則提出估計過度擬合機率的方法(CSCV)。
怎麼看出回測可能過度擬合?4 個警訊
- 參數是一座尖峰,不是一片高原:均線 20 天很好,19 天和 21 天卻很差,代表結果對參數非常敏感。
- 條件越加越多:「均線交叉,而且 RSI 低於 30,而且星期二,而且成交量放大」,每多一個條件,都可能只是在貼合歷史。
- 交易次數很少:十年只交易 15 次,統計上很難和運氣區分。
- 樣本外明顯變差:調參數的期間很好,換到新資料就失靈,是最直接的證據。
怎麼降低過度擬合?5 個做法
| 做法 | 說明 |
|---|---|
| 記錄試過的組數 | 試了 500 組才找到的結果,要比只試 5 組的結果更保守看待 |
| 保留樣本外資料 | 一段完全不拿來調參數的資料,最後才用來驗證 |
| 規則越簡單越好 | 每個條件都要說得出理由,而不是「加了之後績效變好」 |
| 看參數高原 | 選一個前後鄰近參數都還可以的區域,而不是單一最佳點 |
| 滾動驗證 | 讓參數在不同時期反覆接受新資料檢驗 |
樣本外測試與滾動驗證的具體做法,見〈樣本外測試怎麼做?〉。
用 AI 調參數為什麼更要小心?
以前寫一組回測要花半天,現在請 AI 一次產生幾十種變化只要幾分鐘。試驗成本降低,假發現也會跟著變多。如果請 AI「把參數調到績效最好」,它會非常盡責地完成,但那正是上面模擬裡「試 10,000 次挑最好」的做法。
比較好的使用方式,是讓 AI 幫忙寫驗證流程:切分樣本內外、記錄每次試驗、畫出參數高原,而不是只幫忙找最佳參數。量化交易部落格 Robot Wealth 也提醒,AI 降低實驗成本後,錯誤的發現會和真正的發現一起增加。上面模擬的核心邏輯只有這幾行:
sig = rng.choice([-1.0, 1.0], size=(10000, 1000))   # 10,000 個隨機多空策略
ret = sig * market                                   # 策略每日報酬
s_in = [sharpe(x[:500]) for x in ret]                # 樣本內夏普值
s_out = [sharpe(x[500:]) for x in ret]               # 樣本外夏普值
常見問題
參數最佳化一定會造成過度擬合嗎?
不一定,但試的組合越多,風險越高。關鍵是保留沒用來調參數的樣本外資料,並記錄總共試過多少組。
回測期間拉長,就能避免過度擬合嗎?
拉長期間有幫助,但不能保證。Bailey 等人的研究把足夠的回測長度視為必要條件,但不是充分條件;試的組數太多,長期回測也可能過度擬合。
夏普值多少才算可信?
沒有單一門檻。同樣是夏普值 2,試 1 組得到和試 10,000 組挑出來,可信度完全不同。要一併看試驗次數與樣本外表現。
過度擬合和未來函數哪個比較嚴重?
兩者都會讓回測偏樂觀。未來函數是程式錯誤,修正後通常能立刻看出差異;過度擬合較難察覺,需要用樣本外測試檢驗。
風險揭露
本文模擬數字來自亂數產生的假想市場與隨機策略,不是任何商品的實際績效,也不代表任何策略的獲利能力。回測只能檢驗規則在過去資料上的表現,不保證未來結果。期貨與選擇權具高度槓桿,可能產生超過原始保證金的損失;程式交易另有程式錯誤與系統異常等風險。本文不構成投資建議,亦不推薦任何策略或工具。
官方教育資源
| 機構 | 資源 |
|---|---|
| 臺灣期貨交易所(TAIFEX)期貨及選擇權數位學習網 | 期貨與選擇權基礎教材 |
| 證券暨期貨市場發展基金會(證基會) | 投資人教育與宣導 |
| 金融智慧網(金管會) | 金融知識與風險意識 |
| 中華民國期貨業商業同業公會 | 期貨業資訊與投資人專區 |
| 證券投資人及期貨交易人保護中心(投保中心) | 爭議調處與投資人保護 |
延伸閱讀
- AI寫交易策略可以直接用嗎?回測之前先看懂這 6 個陷阱
- 未來函數是什麼?回測偷看明天資料的 5 種寫法一次看懂
- 樣本外測試怎麼做?訓練期、測試期與滾動驗證這 4 點一次看懂
- 投資心理學完整指南:8 個讓你賠錢的心理陷阱